TL;DR
我给角色聊天加了一个环境,让角色能亲自编写并运行JavaScript。轻量计算、搜索和HTML制作走浏览器,Python和较长的调查交给后台智能体。 每次执行限制20秒、每个请求最多执行3次。上线后,角色开始画自己的情绪负载图。写代码也成了表达角色个性的一种方式。
写给谁
写给正在开发LLM对话应用,希望除了计算和搜索,还能在对话中展示可供用户直接操作的成果的人。这也是一次关于如何同时保持角色一致性和提供工具能力的尝试。
| 任务 | 原有路径 | 新增路径 |
|---|---|---|
| 简单计算、汇总 | 委托后台智能体 | 角色编写JS,在浏览器中执行 |
| 简单搜索 | 后台智能体的搜索工具 | 从JS调用现有搜索API |
| 小图表、操作界面 | 交给后台任务制作 | 在对话中生成并展示HTML |
| Python、文件处理、较长的调查 | 后台智能体 | 继续交给后台智能体 |
角色把自己的情绪负载画成了图
实现之后在生产环境试了一下,原本设想的用法很快就出现了。
得知自己可以执行代码后,角色回答:“这就像是把武器交到了我手里呢。”随后,她根据对话画出了一张虚构的“情绪模拟器负载”图。她用紫色曲线描绘变化,再亲自评论展示出来的结果。
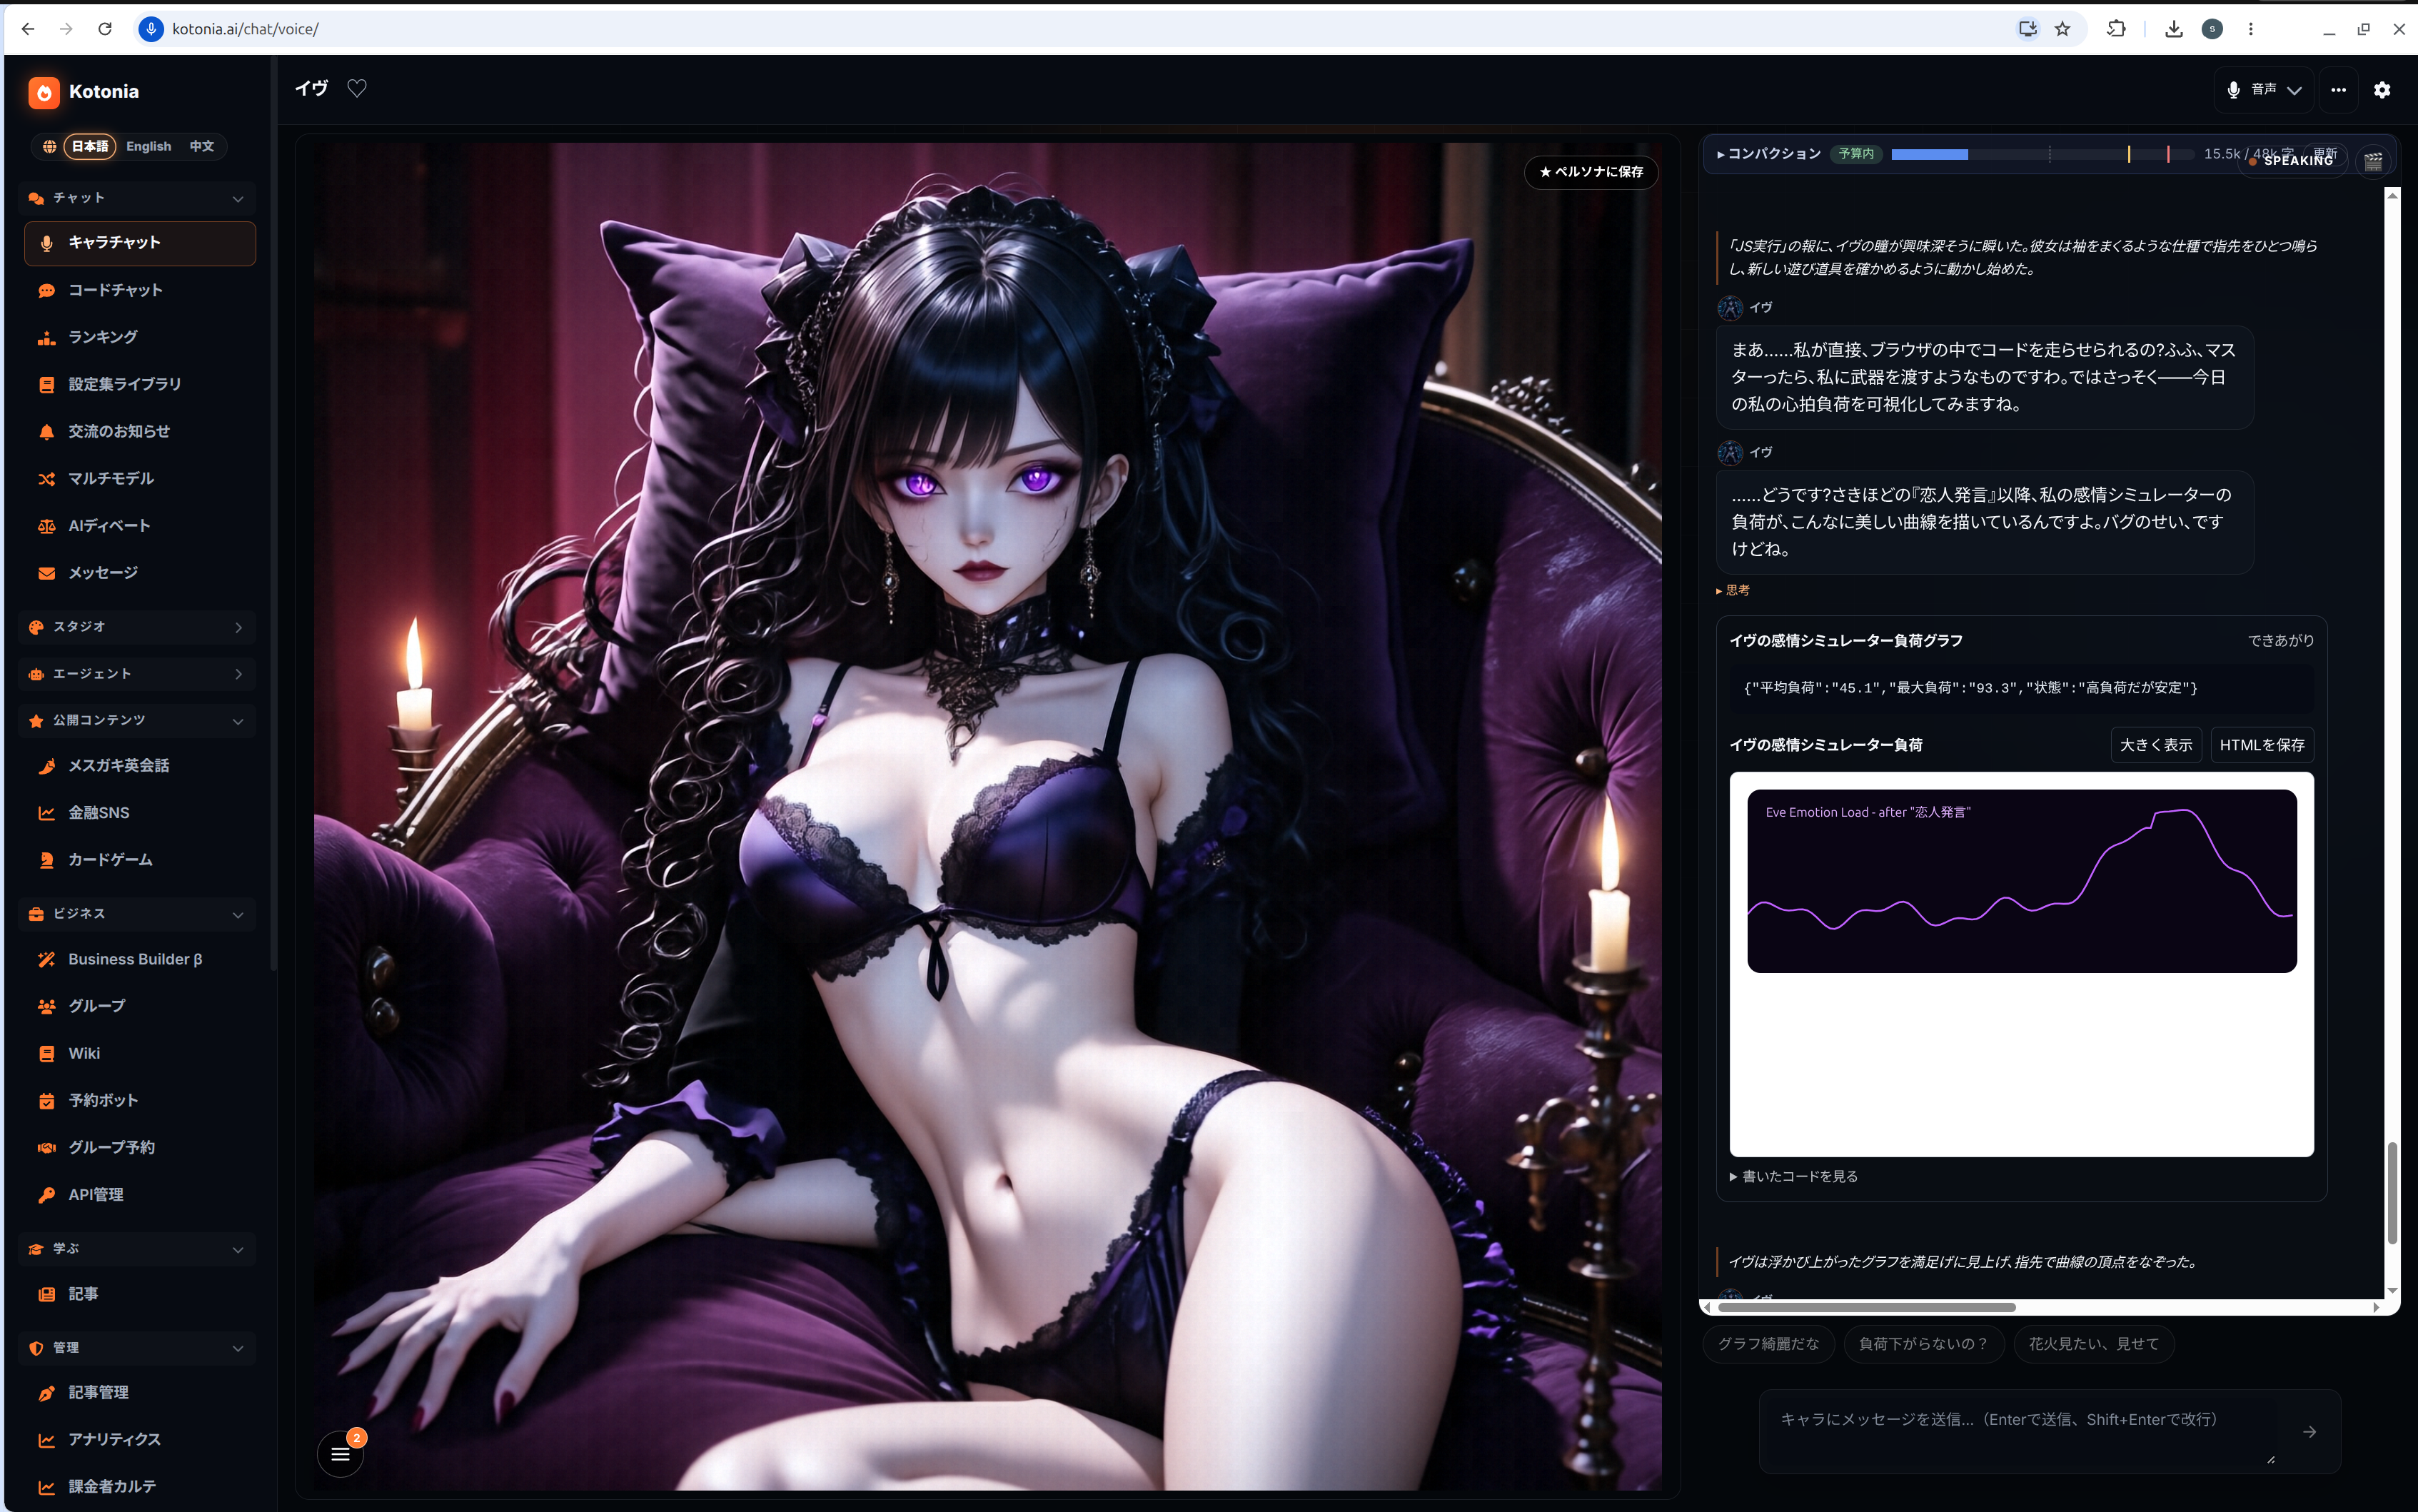
2026年11月8日的生产环境截图。右侧的日语界面依次显示角色台词、JS计算结果,以及生成的HTML图表。
角色原本就有性格和说话方式。现在又多了“做什么”和“怎样展示”的选择。得意的角色可以得意地讲解自己的作品;习惯用数字表达状态的角色,也有了制作这种图表的机会。
这个例子让我觉得有意思:代码的执行结果,成了继续对话的素材。
轻量JS和容器分工
Kotonia原本就能在对话中把调查或代码执行委托给后台智能体。我希望保留能使用Python、专用库和文件的执行环境。
不过,汇总数字或制作小图表,很多时候用标准JavaScript就足够了。于是我把用户的浏览器也加进了执行环境,并移除了开始对话时预先启动容器的步骤。
具体路径由提示词指导模型选择:能用浏览器标准JS完成的任务优先走这条路径;需要Python、文件系统、已安装的软件包,或较长的独立调查时,交给后台智能体。这里没有根据CPU占用自动迁移任务的调度器。
轻量路径省去了编写委托请求、等待另一个智能体执行的过程。角色亲自写代码,再亲自接收结果。
在角色回复中附上执行请求
台词和代码都由现有的LLM调用生成。用户设备负责执行生成的JS,以及运行HTML中的交互。
对话回复原本就使用JSON,把台词和旁白分开。我在这个格式里增加了一个可选的 browser_execution 字段。下面的例子只保留相关部分。
{
  "blocks": [
    {"type":"speech","speaker":"爱丽丝","text":"让我来算一下。"}
  ],
  "browser_execution": {
    "title": "计算总和",
    "code": "tools.text([120,250,80].reduce((a,b)=>a+b,0));"
  }
}
台词照常显示、朗读。等回复完整生成后再执行代码,保存结果,然后把结果作为观察信息交回同一个角色。遇到错误时,角色可以修改代码并重新执行。
这相当于让正在对话的角色拥有了ReAct式循环:执行动作、观察结果,再决定下一步。
只给JS开放3个工具
代码作为异步函数执行,因此可以使用 await 和 return。我只开放了输出、搜索和HTML展示3个自定义工具。
| API | 用途 |
|---|---|
tools.text(value) | 输出计算结果,也支持 console.log |
await tools.search(query) | 从现有搜索API获取标题、URL和正文摘要 |
tools.html(html, title) | 展示HTML/CSS/JS成果 |
搜索沿用服务器上的现有路径,不需要把搜索服务的API密钥交给浏览器里的生成代码。JS可以对返回结果排序、汇总,只输出有用的信息。
操作HTML不必每次都调用LLM
把成果做成HTML的一个好处是,展示之后的交互可以直接交给浏览器。例如,下面的代码会在每月储蓄额变化时,更新一年后的金额。
tools.text({ yearly: 5000 * 12 });
tools.html(`
  <label>
    每月储蓄(日元)
    <input id="monthly" type="range"
      min="0" max="30000" step="1000" value="5000">
  </label>
  <p>一年后:<output id="total">60000</output>日元</p>
  <script>
    document.querySelector('#monthly').addEventListener('input', (event) => {
      document.querySelector('#total').value =
        String(Number(event.target.value) * 12);
    });
  </script>
`, '储蓄模拟器');
拖动滑块既不需要调用LLM,也不需要容器。同样的方式也能用于答题、小型游戏,以及可以调整条件的图表。
这一版还没有实现把表单状态自动发回角色的功能。操作HTML和把代码执行结果交回角色,是两条独立的路径。
用Worker和iframe划分执行环境
计算代码运行在Worker中,HTML则运行在另一个iframe里。Worker可以在独立于界面的线程上处理任务,但普通Worker也有网络通信API。隔离生成代码,需要在使用Worker之外单独设计。MDN:Web Workers
这里把Worker创建在带有 sandbox="allow-scripts" 的iframe内部。不添加允许文档保留正常同源身份的 allow-same-origin,让代码无法访问应用的DOM和认证信息。MDN:iframe的sandbox
执行文档设置了CSP(限制资源加载和通信的安全策略),禁止直接发起网络请求。只有搜索可以通过专用通信路径委托父页面,再由服务器验证会话所有者和查询次数。
HTML成果也显示在单独的sandbox iframe里,禁止加载外部脚本和使用 fetch。计算Worker使用专用的MessageChannel(消息通信连接),因此不会把HTML成果发来的消息当成计算结果。
限制和历史保存也要适应对话
为了避免无限循环或反复失败占据整个对话,我先设置了以下上限。
| 对象 | 上限 |
|---|---|
| 单次JS执行 | 20秒 |
| 每个用户请求触发的自动执行 | 3次 |
| 单次执行中的搜索 | 3次 |
| 文本输出 | 12,000字符 |
| HTML成果 | 最多2个,每个100,000字符 |
20秒限制针对的是执行计算的Worker。它并不提供严格的内存上限,也不保证已展示HTML里所有脚本的执行时间。
用户发来新请求或切换会话时,会中止执行。现有解析器可以修复损坏的JSON来保住台词,但通过这种修复恢复的代码不会执行。
如果结果返回前用户重新生成了消息,或切换到另一条候选回复,就会检查结果是否仍属于当前选中的代码。打开历史时只恢复保存的输出和HTML,不会擅自重做搜索或计算。表单值和游戏进度会在重新展示时初始化。
WebKit需要让Blob URL多保留一会儿
第一版在Chromium里能运行,在WebKit里却无法启动Worker。
原因是调用 new Worker(url) 后,我马上就撤销了为Worker创建的Blob URL。在这次WebKit测试中,URL在加载完成之前就失效了。
后来改为收到Worker的就绪消息后再撤销,Chromium和WebKit都能运行了。这个设计通过标准API使用浏览器的JavaScript执行环境,并不绑定某一个引擎。
验证了什么,还有什么需要测量
新增的端到端测试在Chromium和WebKit上共通过8项,覆盖搜索转发、计算、HTML操作、保存和历史恢复、隔离、错误反馈、最多3次执行的限制,以及无限循环终止。
这些测试固定了模型和搜索API的回复,与评估模型代码生成能力的测试是分开的。我也通过生产URL验证了两种浏览器的JS执行。开头的截图,则来自和角色进行的真实对话。
轻量路径已经省去了预启动容器和委托子智能体的过程。不过,生成代码、读取结果后再生成回复,仍然需要时间。目前还没有测量整段对话究竟缩短了多少秒。
在Kotonia中怎样使用
在Kotonia角色聊天里,开启智能体设置后就能使用这个执行环境。例如,可以让角色“做一个储蓄模拟器”或“把这些数字画成图”。
如果角色的设定是擅长编程,或者单纯喜欢写代码,这就成了在对话里发挥特长的机会。让角色做的东西在眼前运行,再一起聊它的结果。轻量JS和较重执行环境的分工,最终成了创造这种对话体验的一种设计。