概要
让角色说「今天就到这里吧」,合成语音有时会在原台词结束后继续说下去。怎样找到剪切点,同时保留台词的最后一个音?我们先找停顿,再核对前后的转写,最后把文字对齐到录音的时间轴上。一次生产环境的冒烟测试中,这套方法完整保留了原台词,去掉了约 2.9 秒的尾部。
原台词和剪切前后的音频
原台词是「今日はここまでにしよう。」(今天就到这里吧)。 第一段音频后面还有一句「明日はまた会おうね。」(明天再见吧)。演示用的两句都是在没有参考音频的情况下合成的,随后拼在一起模拟多说一句的情况。第二段来自实际剪切程序对同一段波形的处理。
剪切前
剪切后
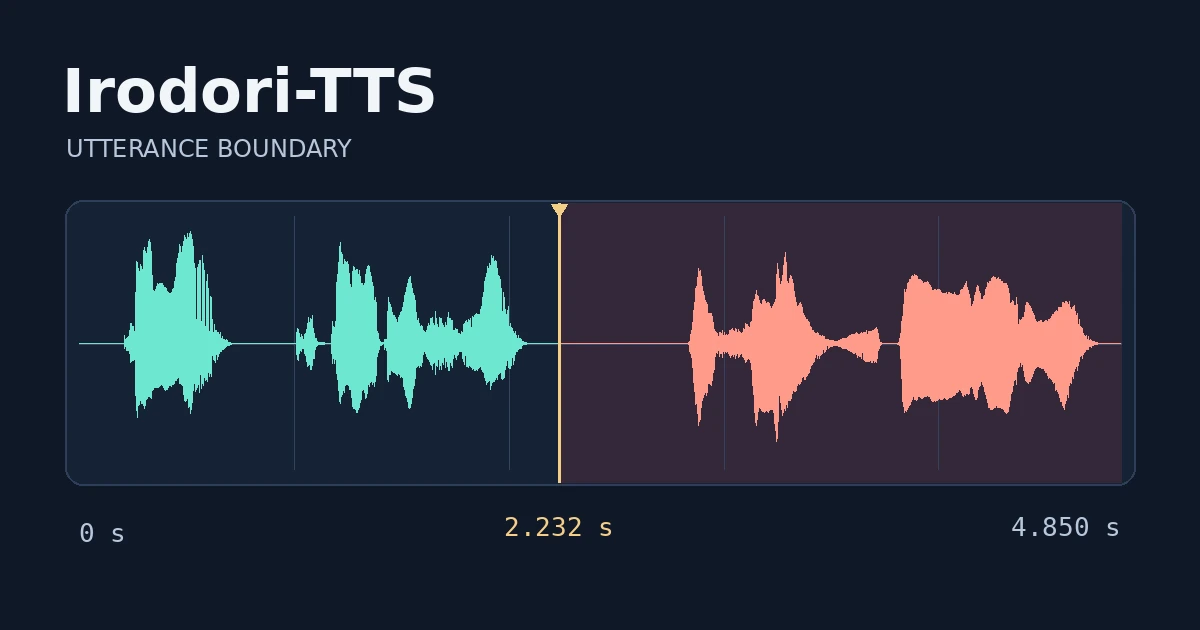
上方的波形图里,绿色是保留的声音,橙色是剪去的片段。这段演示在 2.232 秒处剪开。我们也拿另一段模型实际多说了话的音频跑了生产验证。
用 160 毫秒的停顿找候选位置
原台词中也会有自然的停顿。一段「うん……大丈夫だよ。」(嗯……没事的)中,程序检测到了 1,024 毫秒的间隔。这个位置之前还没说完台词,所以整段音频都保留了下来。要判断这里能不能剪,得先弄清停顿两侧说的是什么。
首先按台词和音频的长度筛选,关注归一化后为 2–28 个字符、含日语且声音偏长的片段。然后使用语音活动检测(VAD)定位有说话声的区间,从后往前检查最多两个至少 160 毫秒的间隔。多看一个间隔,是因为最后一个停顿也可能落在多出来的那句话里。faster-whisper 的 VAD 实现
核对停顿前后的转写
用 Qwen3-ASR 分别转写候选点前后的音频。去掉标点和空格等之后,前半段必须和原台词完全一致。句尾的「ね」「よ」和长音符号「ー」也要匹配。前半段少了一个语尾,就跳过这个剪切点。
后半段识别出词时,再转写完整音频。整段转写必须从台词开始,接下来的两个字符要与单独转写尾部时的开头一致。把呼吸或低语单独截出来,识别器有时也会给出文字。放回完整音频里再查一次,就能验证那段额外发话在上下文中是否依然存在。Qwen3-ASR 官方仓库
在原台词和多出的发话之间剪开
Qwen3-ForcedAligner 把整段转写和波形对齐,给出原台词结束和额外发话开始的时刻。额外发话的对齐起点距离 VAD 找到的下一段发话起点,还要在 100 毫秒以内。Qwen3-ASR 技术报告
只有两边都有余量才剪。剪切点限制在这个区间内,末尾加 15 毫秒的淡出。时间对齐含糊,或者两段发话贴得太近,就播放原音频。
测试也统计了应该保留的样本
在一组单独的验证样本中,我们保留了全部 26 段标注为应保留的声音,其中包含自然停顿和较轻的句尾。语音识别提示可能有多余发话的 6 段里,有 3 段也满足时间边界条件,最终被剪切。这些是选定样本的结果,生产环境的检出率需要用更广的样本来测。
在生产环境的冒烟测试中,一段「今日はここまでにしよう。」之后确实生成了额外发话。程序把音频从 4.480 秒剪到 1.592 秒,剪完的转写和台词一致。判定耗时 471 毫秒。
给判定留有限的等待时间
只有通过长度筛选、且 VAD 找到候选间隔后,才会调用额外的语音识别。共享识别模型或者判定线程繁忙时,这次就跳过。播放最多等待 750 毫秒,超时后返回原音频。
后一句紧贴台词开口,或者台词本身无法被准确转写时,自动剪切依然很难。Kotonia 在角色语音中运行这套处理,只有找到足够明确的边界才剪。