概要
キャラクターに「今日はここまでにしよう。」と喋らせると、合成音声に台本の先が続くことがあった。元のセリフを最後まで残すには、どこで切ればいいのか。発話の間を探し、文字起こしで前後を確かめ、音声と台本の時刻を合わせてから切るようにした。本番の動作確認では、元のセリフを保ったまま約2.9秒の末尾を取り除けた。
入力と切り取り前後の音声
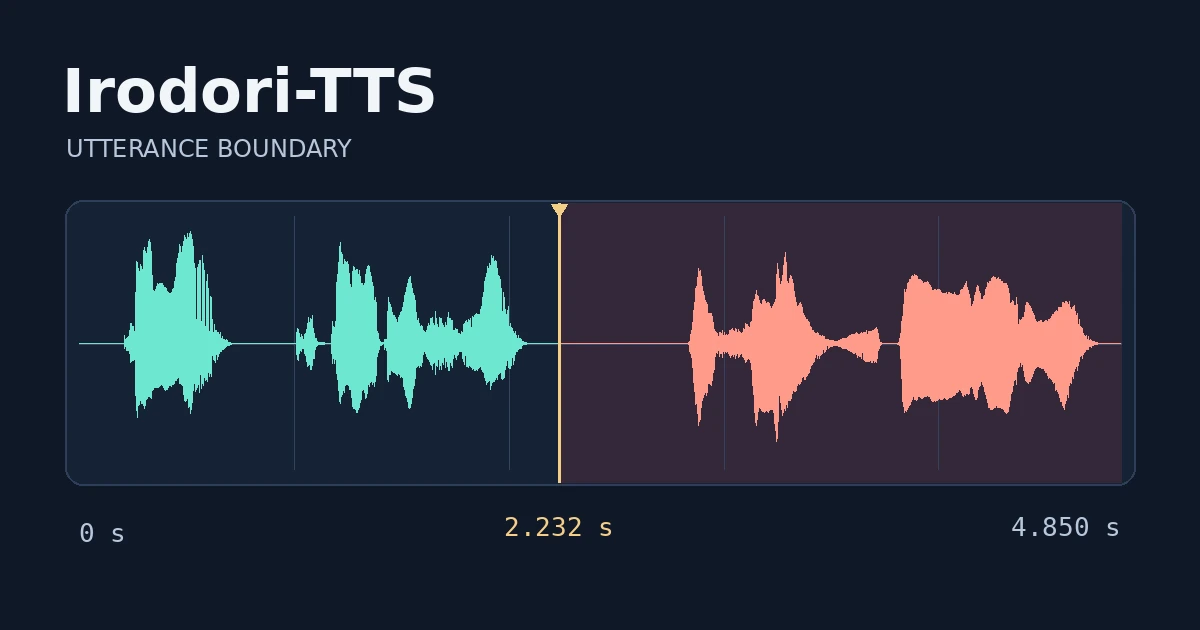
台本は「今日はここまでにしよう。」。切り取り前のデモには、この後に「明日はまた会おうね。」が入っている。2つのセリフは参照音声を使わずに合成し、余分な発話が付いた状況を試聴用に再現した。同じ波形を実装に通した結果が下の2本目だ。
切り取り前
切り取り後
冒頭の波形では、緑が残した音、オレンジが取り除いた区間だ。合成したデモでは2.232秒のところで切れた。本番では実際に余分な言葉が生成された別の音声でも確かめた。
160msの無音を切り取り候補にする
元のセリフの中にも、自然な間はある。「うん……大丈夫だよ。」のテスト音声では、1,024msの間が見つかった。候補の手前までだと台本を言い切っていなかったので、音声はそのまま残した。切れるかどうかは、前後で何を言っているかで決まる。
まず台本の長さと音声の長さを比べる。対象は、日本語を含む正規化後2〜28文字で、文字数に対して長めに出力された区間だ。次に発話区間検出(VAD)で、声がある区間を見つける。音声の後ろから、発話に挟まれた160ms以上の間を最大2つ調べる。最後の間が余計な発話の内部にある場合も拾えるよう、1つ手前まで見る。faster-whisperのVAD実装
文字起こしで前後を確かめる
候補の前半と後半をQwen3-ASRで別々に文字起こしする。前半は、句読点や空白などを正規化して台本と完全一致することを条件にした。「ね」「よ」「ー」も一致判定に含める。語尾が前半から欠けていれば、その位置は見送る。
後半に発話らしい文字が出たら、音声全体も文字起こしする。台本が先頭にあり、続きの冒頭2文字が後半だけの文字起こしと一致したときに次へ進む。短い音を切り出して認識すると、息やささやきから文字が起きることがある。前後の文脈を含めても同じ余分な発話が見えることを確かめる。Qwen3-ASR公式リポジトリ
最後の一音と次の発話の間で切る
文字起こしで余計な発話を確認できたら、音声上の位置を決める。Qwen3-ForcedAlignerで、全文の文字起こしと波形を照らし合わせ、台本の最後の音と次の発話の開始時刻を求める。後半の開始時刻が、VADで見つけた次の発話区間の開始と100ms以内で合うことも確認する。Qwen3-ASR技術報告
切るのは、台本の末尾と余計な発話の両方から余白を取れるときだけだ。その範囲で候補時刻を調整し、切り口に15msのフェードをかける。文字と時刻の対応が曖昧な音声や、十分な余白がない音声は元のまま返す。
検証では切り取りを見送った例も数えた
調整に使ったデータとは別に、自然な間や小さい語尾を含む検証音声を通した。「残す」とラベルを付けた26件では切り取りが発生しなかった。音声認識で余計な発話の疑いが出た6件では、時刻まで確認できた3件を切った。これは選んだ検証音声での結果で、本番全体の検出率には使っていない。
本番の動作確認では「今日はここまでにしよう。」の後に余分な発話が入った1件で、4.480秒の音声を1.592秒まで切り詰めた。切り取り後の文字起こしは台本と一致し、判定処理は471msだった。
会話を待たせる時間に上限を置く
追加の文字起こしを呼ぶのは、台本と音声の長さで絞り、VADで候補の間が見つかったときだ。共用の音声認識モデルや判定ワーカーが空いていなければ、その回の判定は見送る。再生前に結果を待つ上限は750msで、過ぎたら元の音声を返す。
余計な音が無音を挟まずに続く場合や、元の文を正確に文字起こしできない場合は、この仕組みでは切りにくい。聞き分けられる証拠が揃った区間だけに絞って、Kotoniaのキャラクター音声で稼働させている。