はじめに
個人で kotonia というサービスを作っている。中心はキャラクターチャットだが、グループで使う「ワークスペース」もあり、その中に表計算のような共有表がある。
共有表に CSV の取り込みを付けた日、妻に試してもらった。毎日つけている育児記録を、いま使っているアプリから移してみてほしい、と。
アプリには書き出し機能があった。出てきたのはこういうテキストだった(名前と数値は作り物)。
----------
2026/1/5(月)
〇〇ちゃん (0か月10日)

00:30   ミルク 40ml
12:50   母乳 左 15分
13:00   母乳 左 2分 / 右 6分
02:25   うんち   多かった(二日ぶり)
10:55   くすり   K2

母乳合計     左 17分 / 右 6分
ミルク合計    1回 40ml
人に送って読んでもらうための形式としてはよくできている。ただ、表ではない。日付は見出しにしかなく、1 行に値が 2 つ入り、日ごとの合計が記録と混ざっている。表計算ソフトに貼っても 1 列に並ぶだけだ。
妻はこれを自分で別の AI に頼んで CSV に直し、それから取り込んでいた。取り込めはしたが、利用者に毎回それをさせるわけにはいかない。
書き出し機能があっても、そのまま使える形でなければ、記録は実質アプリの中にしまわれたままになる。これは他人事ではない。こちらも利用者のデータを預かる側だからだ。
この記事は、その前後の 2 日で作ったものの記録だ。テーマは 2 つある。
- 利用者がデータを持ち込める・持ち出せる・自分の見方で見られるようにすること(選択肢を増やす)
- それを使うときの面倒を、AI でどこまで減らせるか(摩擦を減らす)
AI は遠慮なく使った。その代わり、データが壊れたり外に出たりする箇所はサービス側が引き受ける、という線を引いた。どこに線を引いたかも書く。
用意した選択肢
持ち出す: 書き出し
共有表は CSV と JSON で書き出せる。
- CSV は表計算ソフト向け。Excel が文字化けしないように BOM を付け、日時は見ている人の現地時刻、メンバーの列は名前で出す
- JSON は別のツール向け。元の値(日時は UTC、メンバーは ID)と表の構造をそのまま出す
書き出した CSV は、そのまま取り込み直せるようにしてある。見出しが列名と同じなら、AI を呼ばずに対応が付く。出口と入口が噛み合っていないと、書き出しは「一方通行の出口」になってしまう。
持ち込む: 取り込み
CSV・TSV のファイル、表計算ソフトからコピーしたセルの貼り付け、そして表になっていないテキストを受け付ける。日本語版 Excel が出す Shift_JIS の CSV も読む。
自分の見方で見る: カスタム表示
表のデータを、自分の欲しい形のダッシュボードにできる。HTML を書けなくても、「月ごとのミルクの量を棒グラフで」と書くか、デザインの画像を貼れば、AI が表示を書く。
AI に任せたこと
どれも「人が手でやると面倒だが、間違えても後から直せる」作業だ。
| 作業 | AI がやること | 所要時間(実測) |
|---|---|---|
| 列の対応づけ | ファイルのどの列が表のどの列か | 未計測 |
| 新しい表の設計 | 列名・種類(数・日付・選択肢…)の提案 | 7〜12 秒 |
| 読めない値 | ミルク → 選択肢の「ミルク」など | 3〜5 秒 |
| 表でないテキスト | 行の読み方(パターン)を書く | 15〜32 秒 |
| カスタム表示 | HTML を書く(直すだけなら 7 秒ほど) | 33〜60 秒 |
AI は自宅の GPU で動かしているローカル LLM で、ここに送るデータはどれも外部のサービスに出ない。これはこの機能では選択肢ではなく前提にした。育児記録や家計簿を、他社の API に送ってよいかを利用者に毎回判断させたくない。
冒険譚: 135 件を取り戻すまで
「CSV が読めれば十分」は最初の実例で外れた
取り込みは最初、CSV 前提で作った。値の読み方(全角数字、120ml の単位、2026年11月16日、午後3時、○ や 済)はコードの規則で読み、AI には「この列はあの列」という対応づけだけを出させる。テスト用に作った汚い CSV は問題なく通った。
そして最初の実データが、冒頭のテキストだった。表ですらない。ここからは、妻のファイルをそのまま入れられるようにするまでの話だ(試したのは開発環境で、データは手元から出していない)。
AI に「読み方」を書かせる
1 行ずつ AI に変換させる手もあった。ただ、1 か月分で数百行あり、遅いうえに、どこをどう変えたかが追えない。
そこで、AI にはテキストの先頭を見せて読み方だけを書かせることにした。具体的には、行のパターン(名前付きグループの正規表現)だ。「この形の行は日付の見出し」「この形の行は記録で、時刻・種類・量はここ」「合計の行は読み飛ばす」。パターンを全行に当てるのはコードがやる。
正規表現を書くのは AI なので、変なパターンが来てもサーバーが固まらないように、バックトラックしない正規表現エンジン(Rust の regex)で動かし、サイズにも上限を付けた。
1 回目: 124 / 135
正解は記録 135 件(ミルク 102・母乳 25・うんち 5・くすり 2・吐く 1)。1 回目に読めたのは 124 件だった。しかも中身が足りない。
- 時刻の列がない。行には合っているのに、時刻を拾うグループがなかった
- 種類の列がない。種類ごとにパターンを分けて書いた結果、「ミルク」をパターンの中の固定の文字として書き、値として拾っていなかった
- 日付が空。これは私のバグだった。見出しを読むたびに引き継いだ値を全部消していたので、日付の直後の「〇〇ちゃん」の行で日付が消えていた
直したのはどれも汎用の検査だ。特定のアプリ向けの規則は 1 つも足していない。
- 見出しは外側から内側への階層として扱う(日付を読んだら内側の名前を消し、名前を読んでも日付は残す)
- 記録の行に、どのグループにも入らなかった数字が残っていたら「値を落としている」として AI に返す
- 記録の行のパターンが複数あるなら、それぞれ種類を値として拾うことを必須にする
- 一度も値が入らない列も差し戻す
先頭 80 行の外にあった行
検査を足しても、ときどき 11 行が読めないまま合格になった。理由は単純で、AI に見せる先頭 80 行に「くすり」や「左右両方の授乳」の行がなかった。珍しい種類の行は、ファイルの後半にしか出てこない。
パターンを当てるのは機械的で安いので、評価はファイル全体で行うことにした。AI に見せるのは先頭だけでも、読めなかった行は後半のものも含めて具体的に返し、最大 4 回まで書き直させる。いまは 3 回試して 3 回とも 135 件すべてを読めている。
同じ形の問題は、表の設計でも起きた。選択肢の列を AI に提案させると、先頭 30 行に出てくる「ミルク・母乳・うんち」しか選択肢にならず、後半の「くすり」が取り込めなかった。選択肢はファイル全体の値で補うようにした。
**AI に見せる量には限りがある。けれど、確かめる量に限りはない。**これは今回一番効いた考え方だった。
件数は合っていたのに、中身が壊れていた
135 件が入り、エラーも 0 件。ここで終わりにしかけた。ただ、AI が提案した表で「授乳時間」が 1 列しかないのが気になった。左右両方の授乳の行は、どう入ったのか。データベースの中身を直接見た。
左 2分 / 右 6分 が 26 分、左 15分 / 右 3分 が 153 分、左 10分 / 右 10分 が 1010 分として入っていた。
原因は 2 つ重なっていた。
- 表の設計の段階で、AI が左の分と右の分を 1 つの数の列にまとめていた。値は
2 6のようにつながって渡る - 私が書いた数の読み取りが、
1 200のような空白区切りの千の位を読もうとして、空白とカンマを全部消してから数字を探していた。2 6は黙って 26 になる。同じ理由で2,5は 25 になる
どちらか片方だけなら事故にならなかった。2 つ揃うと、エラーを 1 件も出さずに値が壊れる。
直し方は「どちらとも取れるものは、黙って決めない」だ。カンマは「数字の後で、ちょうど 3 桁が続く」ときだけ千の位として扱う。それ以外の 2 6 や 2,5 は「数が複数ある」として、取り込み前の問題の一覧に出す。表の設計でも、日付と時刻以外の列には複数の列をまとめさせない。
直した後は、件数ではなく値で確かめた。ファイルには日ごとの合計の行がある(取り込みでは読み飛ばしている行だ)。その合計と、取り込んだ値の合計を突き合わせた。
| ファイルの合計行 | 取り込んだ値 | |
|---|---|---|
| ミルク | 11,650 ml | 11,650 ml |
| 母乳 左 | 277 分 | 277 分 |
| 母乳 右 | 49 分 | 49 分 |
| 件数(ミルク / 母乳 / うんち / くすり / 吐く) | 102 / 25 / 5 / 2 / 1 | 102 / 25 / 5 / 2 / 1 |
件数とエラー 0 件は、正しさについてほとんど何も言っていなかった。今回は気になって中を見たから気づけたが、それは運に近い。確かめるなら、元のデータが自分で持っている答え(ここでは合計の行)と突き合わせる。
サービス側が引き受けていること
AI に大きく任せた分、データが壊れる・外に出る・取り返しがつかなくなる箇所は、AI の判断に預けずコードで押さえた。
書き込む前に必ずプレビューする。 取り込みは、何行入るか、どの値が読めなかったかを見せてからでないと書き込まない。読めない行があるときは「飛ばす」を明示的に選ばないと進まない。
取り込みは取り消せる。 1 回の取り込みは 1 つのトランザクションで、入れた行に印を付けてある。「この取り込みを取り消す」で消えるのは、取り込んだ後に誰も編集していない行だけだ。
読めないものは隠さない。 単位の違う値(ml の列に入ってきた 左5分)も、どのパターンにも合わなかった行も、黙って捨てたり丸めたりせず一覧に出す。手で直す・AI に直させる・空にする、を選べる。
AI は値を書き換えない。 AI が出すのは対応づけ・読み替え・読み方のルールで、全行に当てるのも、最後の型の検査もコードがやる。手で 1 行ずつ入れるときと同じ検査を通る。
カスタム表示は読み取り専用。 AI が書いた HTML は、ログイン情報を持たない隔離した枠(sandbox の iframe)で動く。データは親のページに「読ませて」と頼むしかなく、親が中継するのは読み取りだけだ。書き込みの窓口は、お願いではなく仕組みとして存在しない。
ただ、防げない穴が 1 つある。枠の中のページは、自分自身を別の URL に移動できる。実際に試すと、移動先への通信は出た(直後に表示は止める)。これを許容しているのは、表示から読めるのはグループの共有データだけで、表示を作った人はもともとそれを全部読めるからだ。だから「見ている人ごとに違う情報」は中継に足さない、と決めてある。それを足した時点で、この穴は本物の漏れになる。
おわりに
2 日前、妻の記録はアプリの中で、人に送るためのテキストになっていた。いまは、そのテキストを前処理なしで共有表に入れられる。
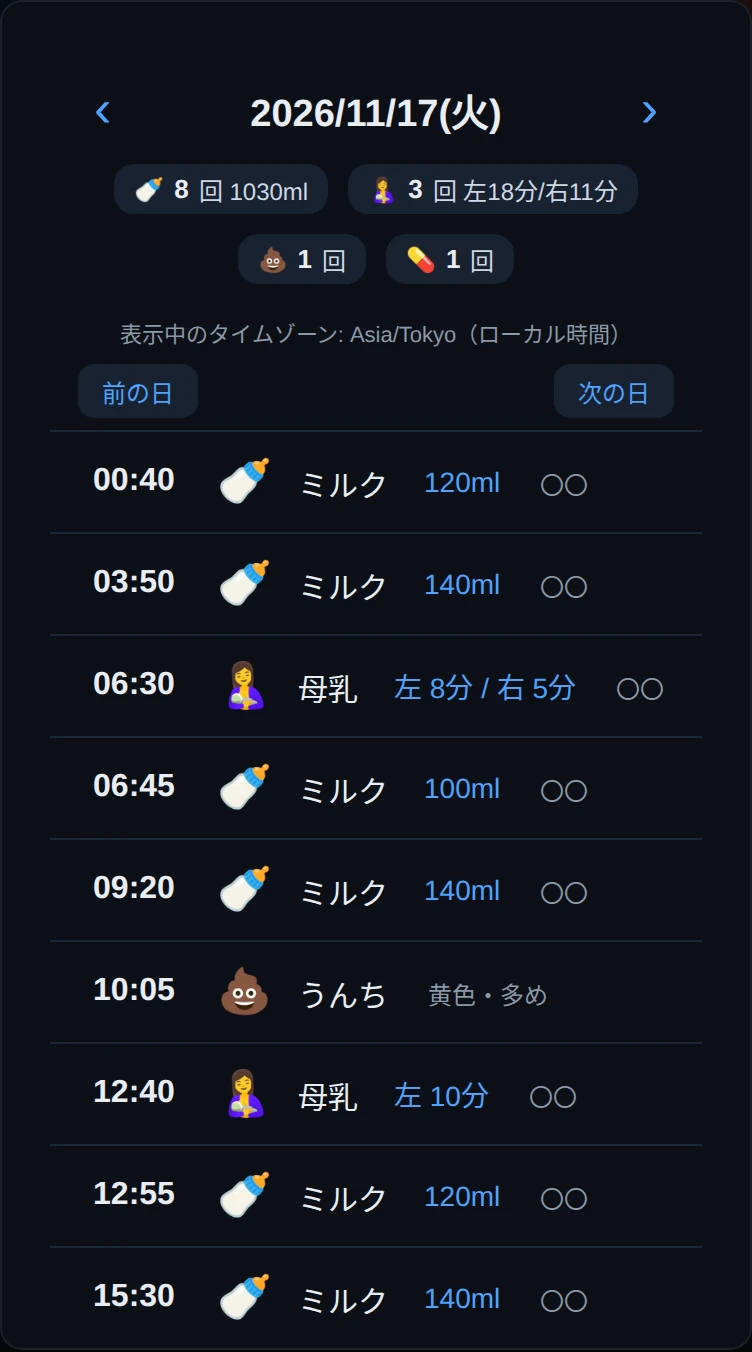
その記録から、カスタム表示で「1 日ごとのタイムライン」も作った。日付を切り替えると、その日の記録と合計が並ぶ。
作っていて思ったのは、データを持ち出せるかどうかを決めるのは「書き出しボタンがあるか」ではなく、「出したものを次の場所で使えるか」だということだ。そこには面倒な変換がつきもので、その面倒こそ AI がよく効く場所だった。ただし、面倒を肩代わりさせるほど、値が黙って変わる危険も増える。だから、その危険はサービス側が引き受ける。
共有表とカスタム表示は、kotonia のグループ機能の一部だ。月額プラン(500 円〜)か前払いのチャージで自分のグループが用意され、kotonia のアカウントを持つ家族などを招待して一緒に使える。